部署配方 · 监控
用 Uptime Kuma 监控机架,别把自己监控到崩溃
Uptime Kuma 是这台机架上最有性价比的服务:180MB 内存、一个 SQLite 文件、一个只回答「它还活着吗」的仪表盘。真正的坑不在软件,而在监控列表本身。二十个监控项在你重启路由器时同时报警,会教会你忽略通知,而一条被忽略的通知比没有通知更糟。
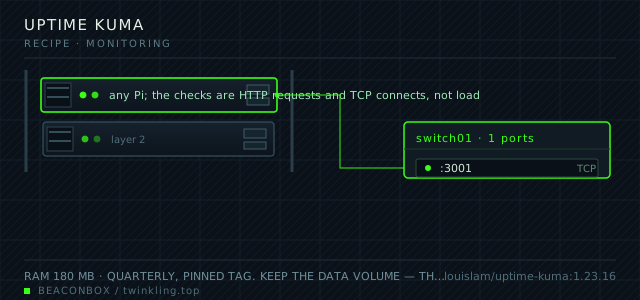
| 容器镜像 | louislam/uptime-kuma:1.23.16 |
|---|---|
| 宿主端口 | :3001/tcp |
| 数据目录 | /srv/homelab/uptime-kuma/data |
| 内存预留 | 180 MB |
| CPU 上限 | 0.25 vCPU (cpus: "0.25") |
| 更新节奏 | quarterly, pinned tag. Keep the data volume — the SQLite schema migrates automatically and there is no downgrade path |
| ARM 兼容 | arm64 native; the image ships a bundled Chromium for the screenshot monitor, which is what makes it 400 MB on disk |
| 宿主 | 容器 | proto | 暴露 | 用途 |
|---|---|---|---|---|
| :3001 | 3001 | tcp | 仅局域网 | dashboard, monitors and the status page you can share |
部署步骤
启动前先建数据目录
官方镜像要求 /app/data 可写。让 Docker 替你建目录,你会得到一个能启动、然后建不了数据库的容器。
run sudo mkdir -p /srv/homelab/uptime-kuma/data sudo chown -R 1000:1000 /srv/homelab/uptime-kuma启动并创建唯一的管理员账号
没有默认密码,也没有对应的环境变量——首次访问时创建账号。请立刻在局域网里完成这件事,别等代理挡在前面。
run cd /srv/homelab/uptime-kuma && docker compose up -d docker logs --tail 20 uptime-kuma # 然后打开 http://192.168.10.20:3001 创建管理员按依赖顺序添加监控项
先网关、再 DNS、再代理、然后是被代理的服务。这样出故障时,这个列表从上往下读就是一次诊断,而不是一屏红色。
run # 后台 -> 新增监控项,类型和间隔照上面的表格填接一个通知渠道,并验证它真的能用
加完渠道先点测试。一个从来没发过消息的通知渠道,就是一个不能用的通知渠道,而你会在最糟的时刻发现这件事。
run # 设置 -> 通知 -> 配置通知 -> 测试 # 然后故意停掉一个容器,等过重试窗口在代理层给状态页加基本认证
状态页可以给家人看,后台不行。认证请在 Caddy 上终止,别让凭据流到容器里。
run docker exec caddy caddy hash-password --plaintext "$(openssl rand -base64 12)" # 把哈希贴进针对 /dashboard 路径的 basicauth 块
九个监控项,每一项都有理由
这里的规则是:每个监控项都必须对应「家里有人能感觉到」的事情。于是清单是九条:六个家人每天会碰的服务、两个网络事实(网关有应答、外网能解析)、一个证书到期检查。
其余的东西——CPU、磁盘、内存——属于指标系统,不属于一个会给你发警报的服务。Uptime Kuma 非常擅长回答「通还是不通」,对任何答案里带数字的问题它都不是合适的工具。
| 监控项 | 类型 | 间隔 | 它失败意味着什么 |
|---|---|---|---|
| dns | TCP 192.168.10.20:53 | 60 秒 | 全家什么都解析不了 |
| proxy | 对机架域名发 HTTP HEAD | 60 秒 | 所有网页服务同时挂掉 |
| jellyfin | HTTP 关键词 'Jellyfin' | 120 秒 | 影音挂了,不影响生活 |
| immich | HTTP 200 检查 /api/server/ping | 120 秒 | 手机照片备份停了 |
| nextcloud | HTTP 200 检查 /status.php | 180 秒 | 文件同步停了 |
| gateway | ping 192.168.10.1 | 60 秒 | 网络本身有问题 |
| wan dns | 查询一个公网域名 | 300 秒 | 上游有问题,内网正常 |
| cert rack | TLS 证书剩余不足 14 天 | 每天一次 | 锁标快没了 |
| nas | TCP 192.168.10.5:445 | 180 秒 | 备份正写进虚空 |
为什么是 60 秒而不是 30 秒
九个监控项按一分钟一次算,一天大约一万三千次检查,对树莓派来说耗时可以忽略。改成三十秒什么也换不来,只会让恢复期的尾巴更长:路由器重启时,更快的轮询只是对同一次故障产生更多失败通知。
重试次数比轮询间隔更重要。报警前重试三次,能把容器重启过程中五秒钟的抖动变成静默——这正是你想要的。
能扛过重启的通知路由
这个服务最有用的功能,是告诉你「你刚才动的东西弄坏了别的东西」。而这只有在通知能扛过重启时才成立:整套服务每次开机的回来顺序都不一样,开机期间触发的监控项就是噪声。
两个设置就解决。通知延迟设成 120 秒,等计时器到时服务已经起来的情况永远不会报警;再把自己的更新窗口配成维护期,计划内的重启从结构上就是静默的。
# 每周日凌晨 4 点开两小时维护窗口
# 后台 -> 维护 -> 新增:cron 0 4 * * 0,时长 120 分钟,应用到全部监控
唯一能真正验证的备份
这是唯一一个备份可以随手验证的服务,所以值得认真做:什么都不用停,跑一次 SQLite 备份命令,用 sqlite3 打开副本数一下监控项条数。条数对得上,备份就是好的。
恢复就是拷文件加重启,十分钟的活。它也是那次能证明你其它备份值得跑的演练。
docker exec uptime-kuma sqlite3 /app/data/kuma.db ".backup '/app/data/kuma-backup.db'"
docker cp uptime-kuma:/app/data/kuma-backup.db /srv/homelab/uptime-kuma/kuma-$(date +%F).db
sqlite3 /srv/homelab/uptime-kuma/kuma-$(date +%F).db "select count(*) from monitor;"
compose 文件
整份文件放在 /srv/homelab/uptime-kuma/compose.yaml。标签固定版本号,不用 latest——树莓派上回滚比升级麻烦得多。
services:
  uptime-kuma:
    image: louislam/uptime-kuma:1.23.16
    container_name: uptime-kuma
    restart: unless-stopped
    ports:
      - "3001:3001/tcp"
    environment:
      TZ: Asia/Shanghai
      UPTIME_KUMA_DISABLE_STATS: "true"
    volumes:
      - /srv/homelab/uptime-kuma/data:/app/data
    security_opt:
      - no-new-privileges:true
    networks: [rack]

networks:
  rack:
    external: true
加固清单
- 状态页公开,但后台在代理层加了基本认证,且唯一账号开启了双因素
- 监控项使用专用凭据,在目标支持的情况下只给只读权限
- 通知 webhook 以环境变量存放而不是写进数据库,这样数据库泄露不会连带把聊天频道交出去
- 容器以 no-new-privileges 运行,且不接触 Docker socket——它并不需要
备份方案
kuma.db 这个 SQLite 文件在容器运行时用 sqlite3 .backup 每晚导出一次,再拷到 NAS。直接复制正在使用的 SQLite 文件可能拿到撕裂的副本;.backup 命令才是安全的做法,这个体量下耗时不到一秒。
上线后验证
- 停掉一个被监控的容器,重试窗口过后只收到一条通知,而不是每次重试各一条
- 局域网设备不登录能打开状态页,但打不开后台
- 整台树莓派重启后,开机窗口内不会收到过期的故障通知
- 每晚的 SQLite 备份能打开,且监控项条数和线上库一致
踩过的坑
- 把监控目标写成容器名而不是局域网地址,会导致从 Docker 网络内部检查是通的,而真实客户端根本连不上。要按客户端的方式去监控。
- 证书监控检查的是代理实际提供的证书,所以必须指向公网域名而不是内网 IP。指向内网会让它永远报「剩余 0 天」。
- Uptime Kuma 默认 20 秒间隔、配上二十个监控项,就是大家说它吵的原因。吵是一个配置选择,不是工具的属性。
- 删除监控项会一并删掉历史。如果你在意状态页上的可用率数字,大规模清理之前先导出数据库。
硬件与选型问答
- 报警用 Uptime Kuma 还是 Prometheus?
- 两个都要,各司其职。Uptime Kuma 在一屏里回答「通不通」,光这一条就值 180MB。Prometheus 加 Alertmanager 回答的是「是不是在变差」——磁盘在涨、内存往上爬、响应时间在漂——只有在服务超过一只手数得过来之后,它们的 1.5GB 才值。
- 监控可以和被监控的服务跑在同一台派上吗?
- 家庭机架里可以——它看不到的故障是整台派挂了,而那种情况不用通知你也会发现。想覆盖这种场景,最便宜的办法是台二手 Pi Zero 2 W,只放一个指向状态页的监控项。
- 历史数据占多少磁盘?
- 60 秒间隔下,大约每个监控项每年 40MB——心跳是按行存的,旧的会按保留设置清理。把保留期设成 180 天,32GB 的卡永远不会是压垮容器的原因。